研究で見てる論文わけわからなさすぎます
ある程度どんなものかは理解できたのですが、中身の数式になると全然わからないです
AIに要約してもらったところで数式難しくて理解する気にもなれないですねー
このままやっていけるのか非常に不安です
研究で見てる論文わけわからなさすぎます
ある程度どんなものかは理解できたのですが、中身の数式になると全然わからないです
AIに要約してもらったところで数式難しくて理解する気にもなれないですねー
このままやっていけるのか非常に不安です
強化学習の説明はいまだに全くできないけど、
概念は確率漸化式に似ていると飲み会で気づかされました。
非常にありがたかったです。
ただ、そもそも確率漸化式がそこまで浸透しているのかがわからないですな。
あとどっちにしても説明して、全くわからんって言われるオチなんでしょうなーかなしい
将来の報酬を評価するために割引率を導入する。
定理・式変形
・
・
展開
・
すべての行動と遷移について確率で重みづけして平均をとる。
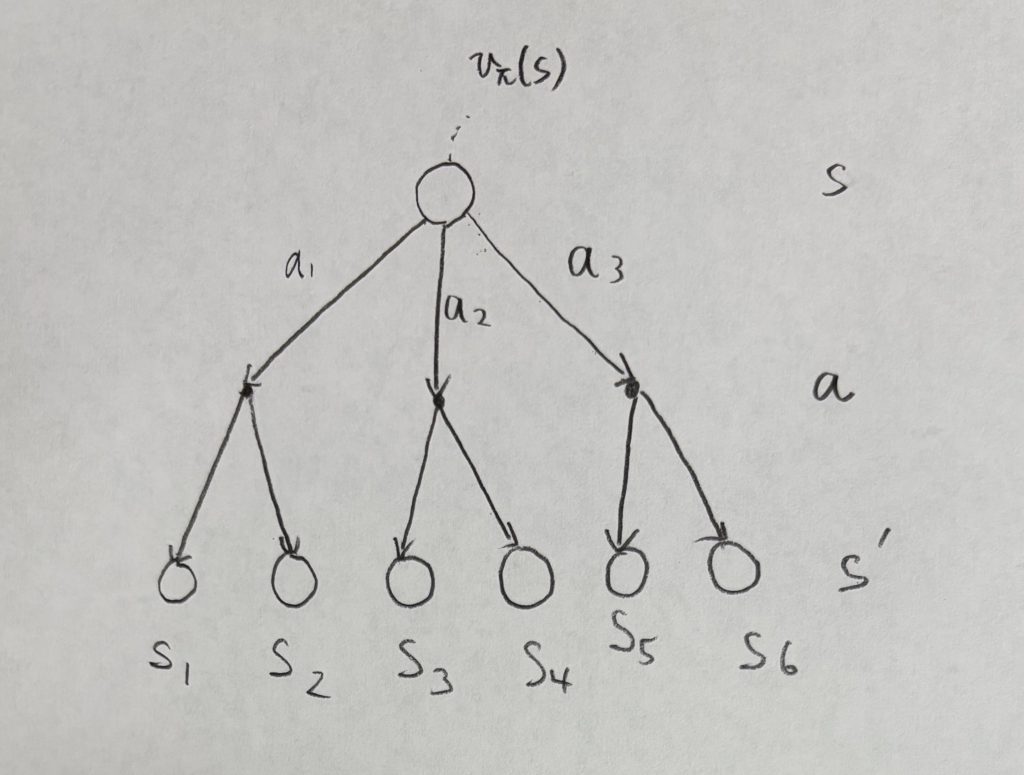
方策 ・・・状態sで行動aを選ぶ確率
状態遷移確率 ・・・状態sで行動aを選んだうえで次状態s’に遷移する確率
報酬関数 ・・・状態sで行動aを選び、次状態s’に遷移した際に得られる報酬
状態 sで行動 を選び、 に遷移する場合
の確率で、の報酬が得られる
この画像の場合、s1~s6までの状態ですべて行うため、足し合わせ、となる
を、次状態に条件づけた に書き換えられれば、次状態での状態価値関数に置き換えられる。
そのために、 に遷移したときの状態価値関数(= 将来の期待収益)を考える。
の確率でに遷移する。
そのときの状態価値関数はとなる。
よって、
このように書き換えられる。
これも第1項と同様に、
状態が s1~s6まであるため、すべての行動・次状態について足し合わせる。
画像のすべての枝について確率で重みづけをして平均を取る。
中身は、即時報酬と次状態での価値
学習は「現在持っている推定値」を「観測した結果(ターゲット)」に近づけるように更新を繰り返す。
モンテカルロ法ではサンプリングを行い、そのデータから推定値を取得するため、ターゲットが収益Gとなる。
Q学習ではターゲットが、ベルマン方程式から、現在取った行動が「どれくらい良かったか」を次の2つで決める。
ターゲットは「」となる。
更新式で書くと、「」がターゲットとなる。
・(割引率):将来の期待をどれくらい重視するか(0に近いほど「目先重視」)
・上のターゲットを使って、実際には次の式で $Q(S_t,A_t)$ を更新する。
この式に基づき、Q関数を繰り返し更新することで最適方策が導くことができる
P.S
もし分かりにくい点や誤りがあれば、コメントで指摘してもらえるとありがたいです。
銀河鉄道999(128分)
1979年公開
さよなら銀河鉄道999 アンドロメダ終着駅 (130分)
1981年公開
※アニメ版と第3作目となる『銀河鉄道999 エターナル・ファンタジー』は一切見ていない上での感想です
まず、単純にストーリーがそこまで面白くないと思いました。
銀河鉄道999(以降前作)は、各惑星に停車して事件が展開される構成です。しかし物語全体が簡素で、停車回数も少ないまま目的地に到達するため、物語の展開がなさすぎるように感じました。また、事件が起きたとして即座に解決しすぎでハラハラ感が全くありませんでした。
さよなら銀河鉄道999(以降後作)は、鉄郎の行動に一貫性が無く、物語を進めるために強引に動機づけをしているようにしか考えられませんでした。
銀河鉄道999
前作の方では、メーテルが誘拐された直後、鉄郎に強力な銃を与えられ、また、メーテルが人間であるという理由だけで解放されるなど、展開に一貫性が感じられません。またメーテルも鉄郎の行動を積極的に制止することが少なく、同行する意味や役割がよくわかりませんでした。
電車の終着駅、惑星メーテル到着時に、鉄郎はメーテルの母プロメシュームに捕まって、機械帝国のねじにされかけます。
その際にメーテルが鉄郎を助け、「志同じく、機械帝国を破壊するために身を犠牲にすることを厭わない人」を送り込んだと言います。
しかし、メーテルの父ドクターバンが入っている?カプセルを投げることによって機械帝国が一瞬で崩壊します。カプセルを投げるだけで崩壊するのであれば、メーテルが人を送り込む必要がないと思いますし、今回のように鉄郎を助けるならば、それまでの人たちも助けてやれよと思ってしまいます。
映画の尺都合的に仕方ないとは思いますが、プロメシュームのやられ方があまりにもあっさりしすぎています。
後作の序盤にプロメシュームとの戦いが大掛かりに描かれていますが、前作では、クレア(銀河鉄道のウェイトレス)が自滅してプロメシュームを倒していることはクライマックスとして盛り上がりに欠けます。
敵の強大さに対して決着の描写が軽く、より単純な方法でも倒すことができたのではないかと思います。
さよなら銀河鉄道999 アンドロメダ終着駅
後作の大きな問題点は、説明が少なすぎます。
前作を見ているだけでは意味がわからず、アニメの方を見ていなければわからないことが多くあると感じました。
全体的に突っ込みどころが多すぎたので割愛します。
物語が冗長な部分が多く、最初の戦いも長時間見せる必要性があったのかが不明です。そこに時間を費やすのなら前作やアニメを見ていない人への説明に時間を使ってほしかったです。
また、個人的には、前作、後作ともに、味方が強すぎてハラハラ感が無く見ていてつまらなかったです。
最後のファウストと鉄郎の決闘のシーンも二人の親子関係を示したいにしても、やる必要性が全く分からなかったです。また、ペンダントの音に気づいて倒すというのがしょうもなさすぎました。もう少し駆け引きを見せてほしかったです。
幽霊電車に人間を積み、その人間を惑星大アンドロメダで機械人間用のエネルギーに変換しているという伏線は見ていて面白かったです。
気になった点は、車掌さんの「元の体に戻る」という発言がいまいちよくわかりませんでした。最初の方のシーンの風呂に関系があるのかと思いましたが、特になさそうだなーと思ってます。
総評
今回は、二つの映画を総合的に判断して、★2となっています。
前作と後作のどちらかを見るのであれば、前作を見ることを圧倒的におすすめします。
なんといっても前作はエンディングの曲がいいのでそれですべてが許されるといっても過言ではありません()
また、後作は情報が欠落している部分が多く、それだけ見てもあまり楽しくはないです。
銀河鉄道999はもう少しストーリーに凝っているものだと思っていましたが、意外にも戦闘シーンが多く驚きました。
僕自身が少し偏見を持ってこの映画を見たので評価が★2なだけで、他の人が見たらもう少し評価が高いのかなと思いました。
今期3戦目ベルーナドームで観戦してきました
なぞ采配のおかげで無事負けました
なぞ采配①8回隅田続投
最近の隅田と比べると今日の隅田は良かったものの、
すごい良いわけではない+球数も100球近く投げているのに変えない意味がわからないです。
監督が毎試合全体的に先発を引っ張りすぎなのが非常に気になります。ウィンゲンター、ラミレス、山田の勝ちパターンがいないとは言え、さすがに中継ぎを使わなさすぎです。
なぞ采配②守備固め
昨日のゴロをファンブルし、カストロの打球の追い方がおかしかったことも踏まえて、カナリオに守備固めを出すべきだったです。岸がいるならライトに長谷川を置けたはずなのに出さずに、結果的にエラーしたことによって3塁打になってしまいました。
なぞ采配③継投タイミング
1点取られた時点もしくは、打撃妨害で1,2塁になった時点で変えるべきでした。その状態なら犠牲フライにならないので甲斐野が無失点で抑えられた可能性がありましたが、満塁になって変えた時点で同点に追いつかれてるのは目に見えてましたね。
ふざけた批判はさておき、レオライナーの新型車両はボックスシートが無くなっていて多摩湖ー西武球場前間の乗車が楽になりそうだなーと思いました。
あとは、後輩と一軍の試合を始めて一緒に見れたのでとても良かったですー
どうでもいい話をいくつかできたので野球の勝ち負けに関係なくとても楽しかったですー
今度行くときは、ボックスシートをとるぞーー
今期ベルーナドーム現地観戦二戦目で無事に勝ちましたー
弁当は食べたいものが売れ切れていたので残念でした
釜めしは具よりも米に出汁がしみ込んでいておいしかったですー
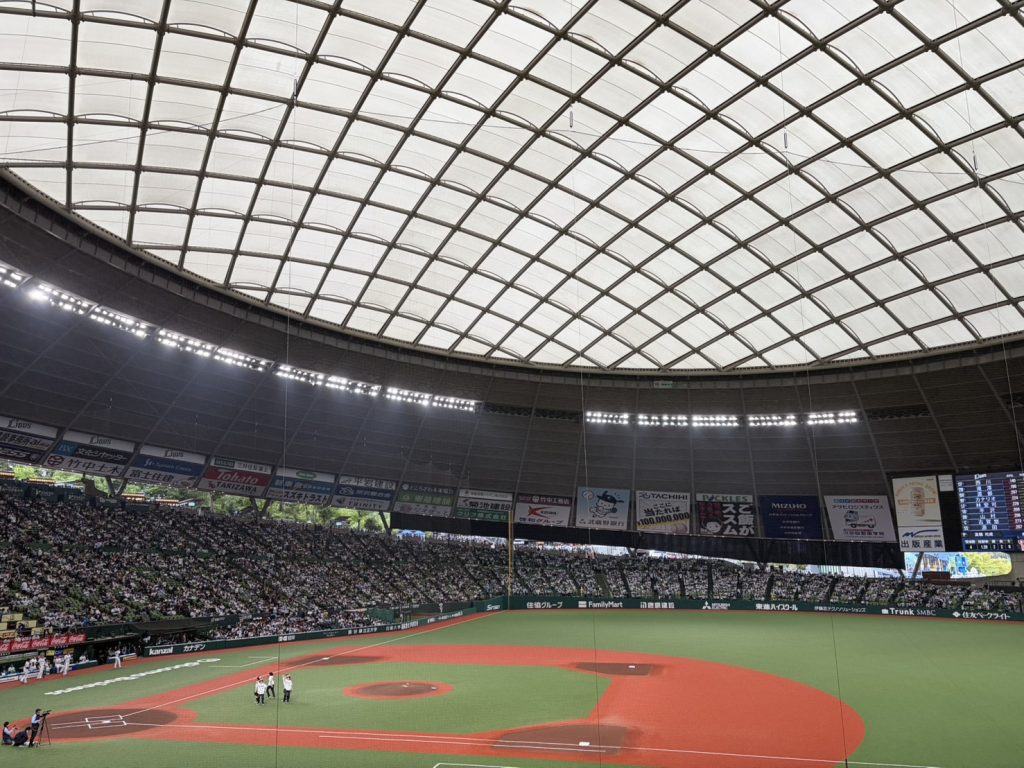
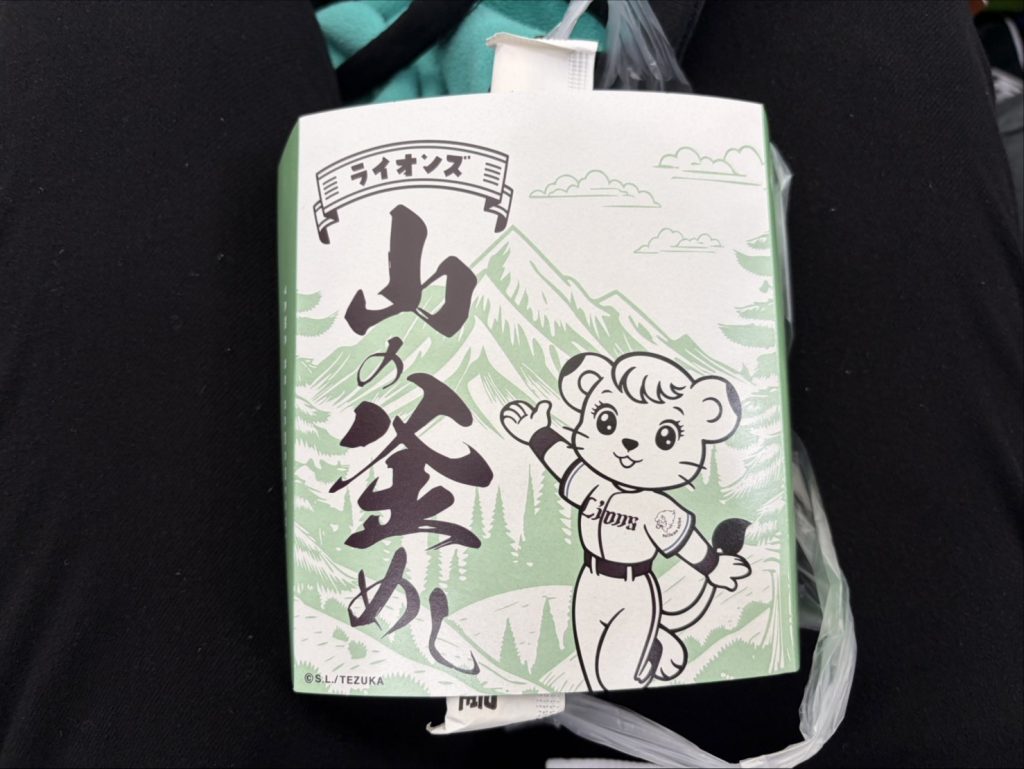
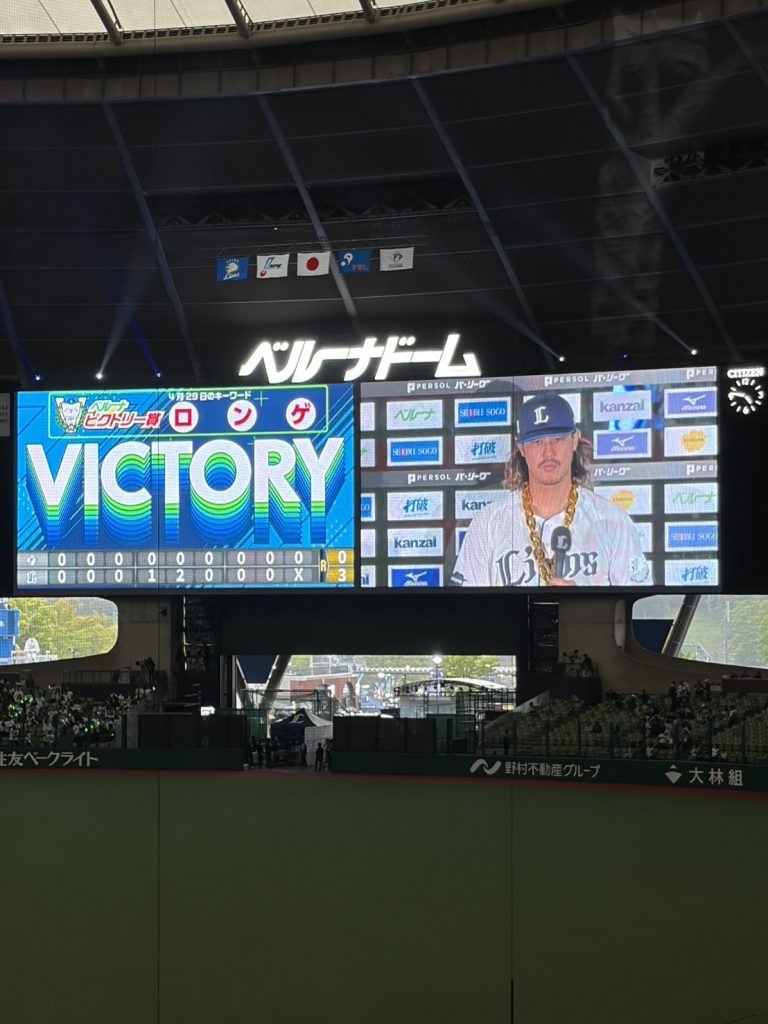
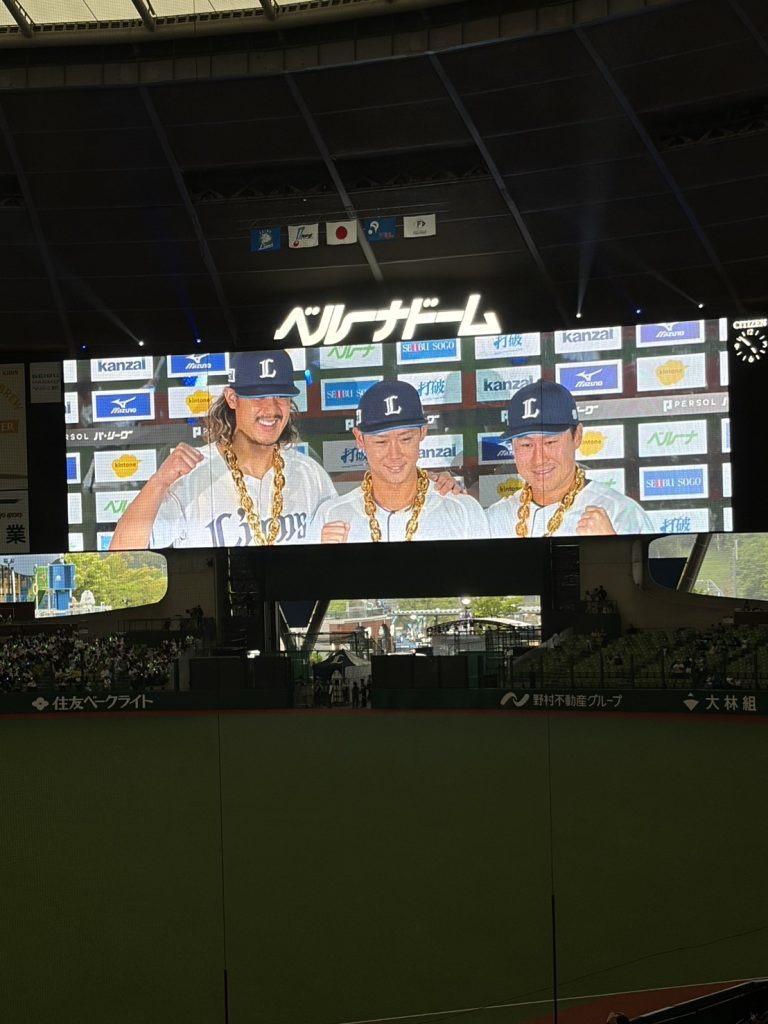
日ハムファンの人と行ったので、3-0で勝ったのは少し申し訳ないですねー
今日先々行抽選で良い席を抑えることができたのでまた6月に行くことが決定して楽しみーー
明日は別の人と観戦しますが、絶対勝つぞー
P.S ポジティブな話題の投稿をしていなかったのでどんどんしていこー
強化学習を研究でやっているのですが、それを他者に簡単に伝えることが全然できません。
累計報酬を最大化とか、最適方策を見つけてとか、行動価値関数がとか言い出したら絶対に伝わらないのでそれっぽく伝えるしかないのですがそれではダメっぽいです。
特に状態価値関数や行動価値関数を求めるためのベルマン方程式というものがあるのですが、これを数式1行ずつ説明したところで絶対に伝わりません。
なので、行動価値関数をどんどん更新して最適行動価値関数を求めるゲームみたいなものを簡単に作って説明したのですが全くわからないと言われてしまいました。
状態遷移が3つあり、防御を行う(攻撃を受ける)ごとにパワーが上がり、その分攻撃力が上がるというものです。それに加え、行動価値関数の値を更新式を用いてどのように更新されているかを説明しました。
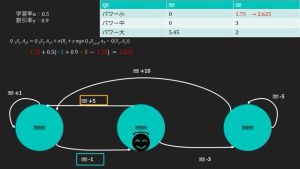
このような形でエージェントがどのように動いたらどのような行動価値関数が定まるかを説明したのですが伝わりませんでした。悲しいです。
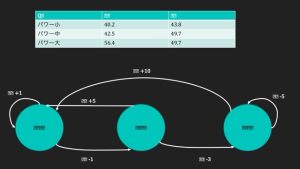
この行動価値関数の値が定まれば、それぞれの状態における最適な行動(期待値が最大となる行動)を選ぶことができます。僕の能力でこれ以上の説明はできません、、、
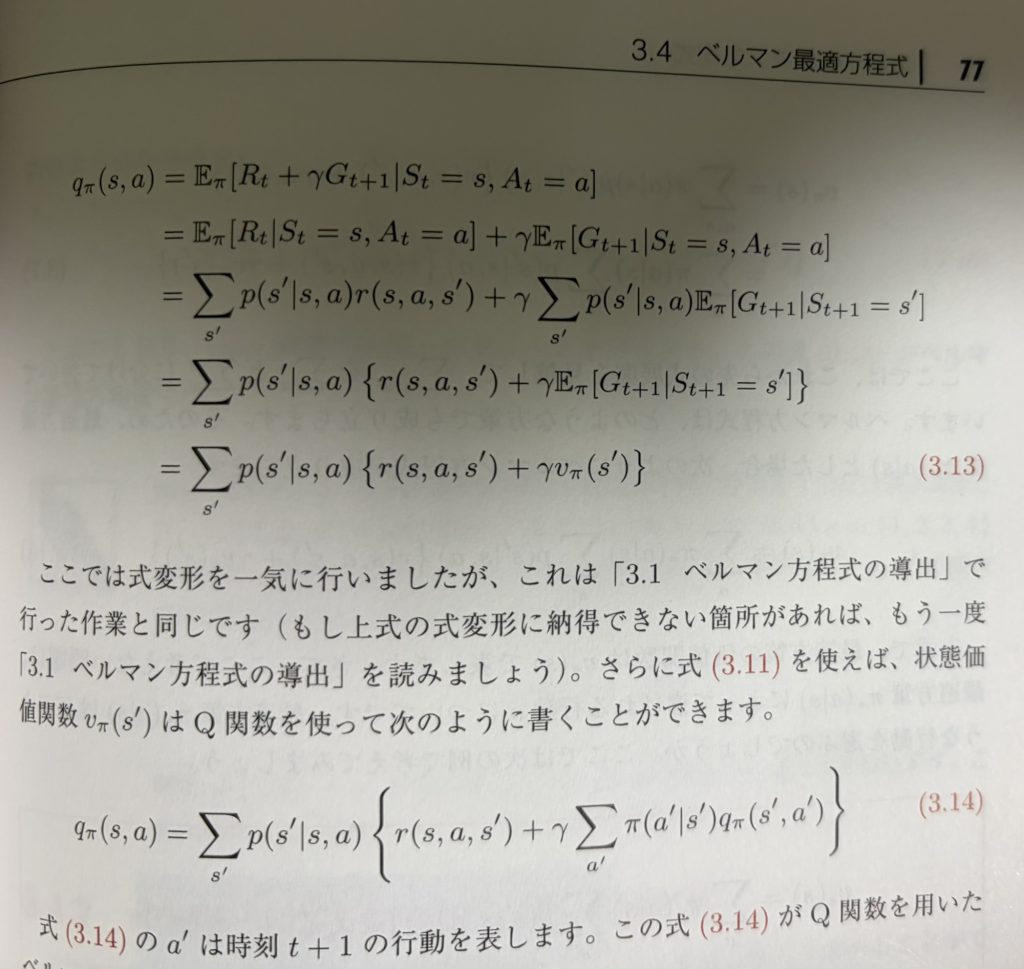
再度になりますが、ベルマン方程式についての説明をしてほしいと言われたのですがこの式を説明したところで分かる人がいるわけがないです。
状態遷移確率とか、報酬関数とか、時刻をtからt+1に移してとか言っても伝わるわけがないからです。
それらの説明をしないでこのベルマン方程式を説明する方法が僕には全く思いつきません。
僕が馬鹿だからそうなんだとは思います。
ベルマン方程式を一言で言うと、現在の報酬と、次の状態での期待値を利用して、現在の価値を決めるというものです。
これだけで分かる人がいたら僕は強化学習の勉強をやめたいです。
数式1行ずつ説明するのは違うと思いますし、ただ一言で説明してもわからないと思いますし、どうやって伝えればいいかがわからなさすぎて辛いです。
これをどうやって説明すれば良いかを考えるのに、
日→月、月→火
で2日連続徹夜しているせいで、これまでの人生で2番目くらいに病んでいて、ご飯もあまり食べられないので今日は早く寝て、明日、明後日は野球を見に行きます
どうにか上手く伝えられるようになりたいなー
グランツーリスモ(原題:Gran Turismo)134 分
2023 年 9 月 15 日公開
『グランツーリスモ』は、ゲーム「グランツーリスモ」のトッププレイヤーを実際のレーサーに育成する「GTアカデミー」の実話を基にした映画です。映画としては悪くはない出来ですが、気になった点が二つありました。
一つ目は、同じサーキットを使い回している点です。同じサーキットを使うことは制作上仕方がないとしても、それが分かってしまうカメラワークであったことは残念でした。また、この映画では主人公の目的がル・マン24時間レース(以降ル・マン)に参戦することですが、ル・マンの撮影がゲーム、実際の映像、ハンガロリンクでの映像の三つに限られているように感じました。さらに、字幕では「ドイツ」と表示されているにもかかわらず、実際のサーキットはスペインであることが明らかなカメラワークとなっていた点も気になりました。
二つ目は、この映画は「ゲーマーが現実のレースを戦いながら成長していく」という内容であるにもかかわらず、現実味が欠けている点です。特に気になったのは以下の二点です。
初戦のGTのレースに出場した際、他のドライバーの悪質なドライブによってクラッシュしているにもかかわらず、クラッシュさせた張本人にペナルティが出ていないことや、それに対する実況の言動が不自然である点です。これに関しては、実際のレースを視聴しないと分からない部分もありますが、現実のレースでは悪質なドライブは厳しく取り締まられることが一般的です。
加えて、多くの場面で現実には起こりにくい演出が誇張されていると感じました。例えば、ドライバーの「気合でスピードが速くなる」といった描写です。モータースポーツは気合だけではどうにもならない要素が多く、常に冷静さが求められますが、この映画では主人公が気合を入れるたびにスピードが速くなるように見える場面がいくつかありました。
『グランツーリスモ』は実話を基にした映画ですが、現実性やカメラワークの面で改善の余地があると感じました。また、実際のレーサーのル・マン参戦後や現在の活動についても触れられていれば、より良かったと感じました。
人間関係が険悪になるというレース以外の要素が少なかったことでレースに注力して見ることができたので非常に楽しく見ることができました。
レースがどのようなものであるかを知りたい!や気になっている!という人には非常におすすめできる映画であると感じました。
大丈夫かな?とかいう人はたいていしょうもない
もちろん体調が悪い人に対して言う分に対しては全然問題がないと思う
問題があるのは他人の課題や研究に口出しする人です
大抵こういう人は本人には言わず、周りの人にあの人大丈夫かな?と言って終わる
大丈夫かな?というだけ言って、本人の手伝いをする気は一ミリもないこれは断言できる。なぜなら手伝う気があるなら周りの人に大丈夫かな?とは言わず本人に言うと思う
そのくせ他人の課題や研究がうまくいってなかったら、自身が手伝っているわけでもないのにキレる
こちらに怒りをぶつけてくるが、そもそも手伝ってもないのに勝手に怒って意味が不明である
こういう人は他人を気にかけている自分に酔っているだけで、
しょうもない人間であるのは明白であるから関わりたくはない
なのになんでこういう人が近くに多いんだろうー嫌だなー